В последние годы вокруг оптимизации под генеративный поиск, включая Generative Engine Optimization (GEO), Answer Engine Optimization (AEO) и LLM Optimization, возник рынок противоречивых рекомендаций. Команды получают советы о внедрении нестандартных текстовых файлов для языковых моделей, создании отдельных «AI-карт сайта» и переписывании технической документации короткими абзацами. Однако, сверяя эти рекомендации с документацией поисковых систем и архитектурой конвейеров Retrieval-Augmented Generation (RAG), становится очевидным, что многие из этих практик не только не влияют на индексацию, но и могут негативно сказаться на отображении сниппетов.
Архитектура генеративного ответа в поиске: базовый индекс, RAG и Query Fan-out
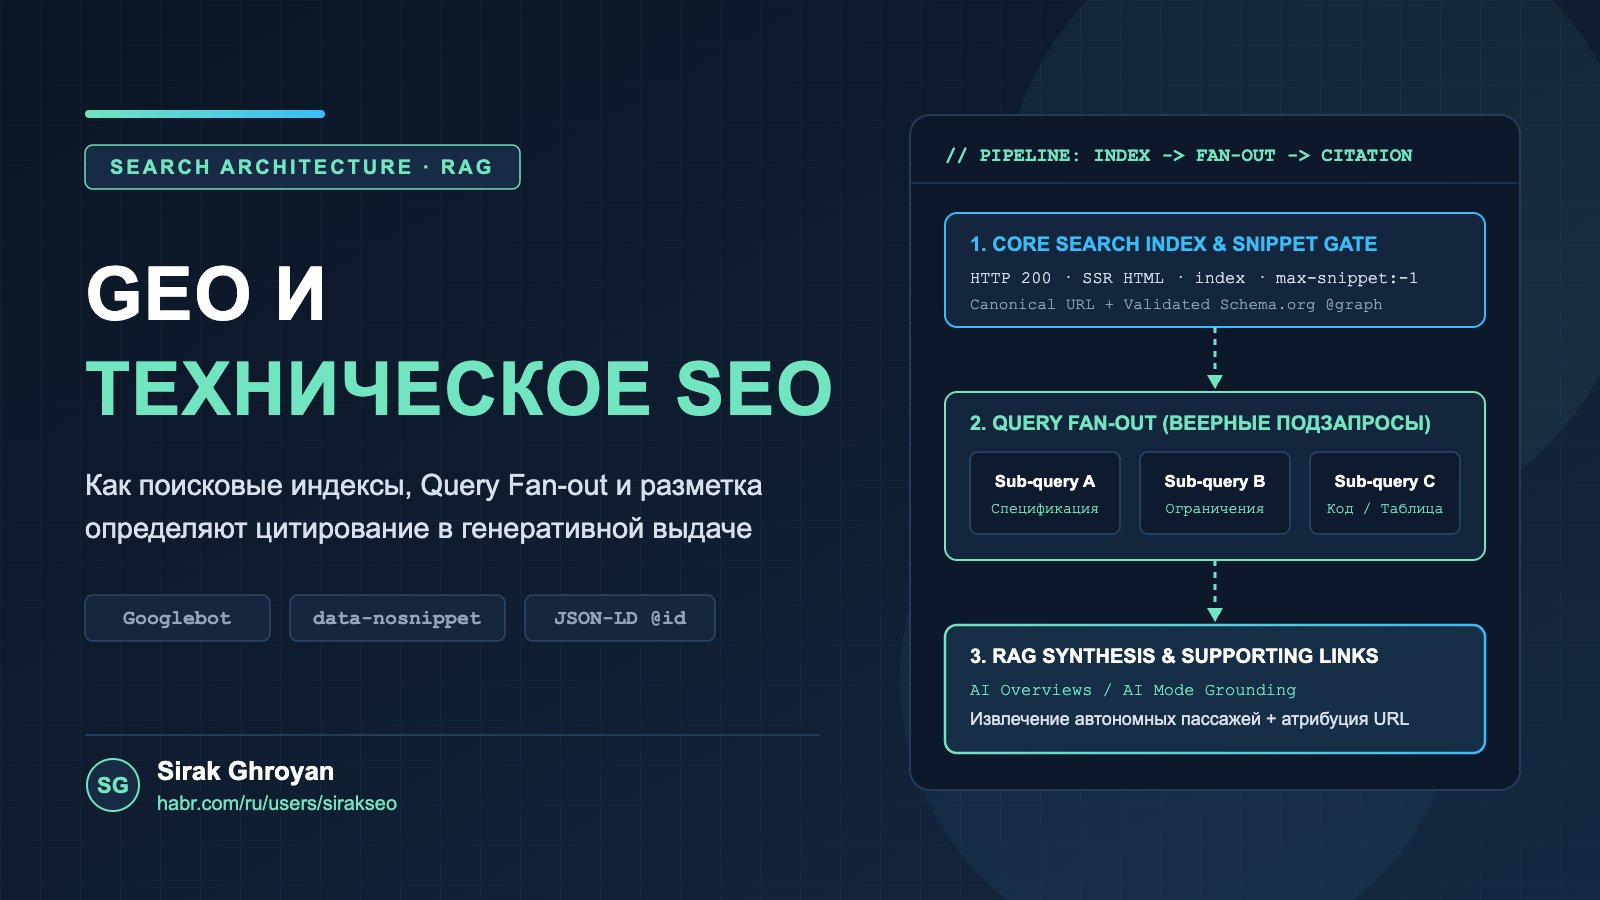
Основное заблуждение при работе с AI-поиском заключается в восприятии генеративного блока как изолированной языковой модели, отвечающей исключительно на основе предобученных весов. На практике генерация ответов в поисковых системах, таких как Google, опирается на конвейер Retrieval-Augmented Generation (RAG), который жестко связан с основным поисковым индексом.
Согласно официальной документации Google Search Central, режимы AI Overviews и AI Mode не имеют отдельного индекса или специальной формы регистрации. Чтобы документ мог стать опорной ссылкой в синтезированном ответе, он должен пройти базовый технический фильтр классического поиска:
- Страница должна быть доступна для обхода основным краулером и находиться в поисковом индексе.
- Страница должна иметь разрешение на формирование сниппета в стандартной поисковой выдаче.
Из этого механизма следуют два важных вывода:
1. Расширение пула цитируемых страниц. Классическая выдача ограничена десятью позициями, но при веерном расширении кандидаты выбираются по набору фоновых подзапросов.
2. Смещение фокуса с уровня документа на уровень фрагмента (пассажа). Для синтеза ответа требуется извлечение конкретного смыслового блока, что снижает вероятность выбора ключевого факта, если он размыт по нескольким абзацам.
Краулеры, индексация и управление сниппетами: где возникает техническая блокировка
Проблемы с видимостью в AI-блоках часто связаны не с качеством текста, а с конфликтами в правилах доступа для роботов и директивами управления превью. Важно понимать различия между Googlebot и Google-Extended. Googlebot отвечает за обход контента для Google Поиска, включая встроенные генеративные функции, тогда как Google-Extended управляет использованием данных сайта для обучения моделей вне основного поиска.
Директивы управления сниппетами, такие как noindex и nosnippet, напрямую влияют на доступность контента для поискового синтеза. Например, использование атрибута nosnippet запрещает текстовый сниппет в выдаче и исключает страницу как источник для AI Overviews.
Доступность исходного HTML и лимиты обхода
Критически важным аспектом является полнота отдачи контента в первичном HTML-ответе. Хотя Google рендерит современный JavaScript, двухфазная обработка может создавать задержки при обновлении данных. Для русскоязычных проектов также необходимо учитывать требования Яндекса, который имеет жесткие ограничения на страницы, возвращающие коды 4xx/5xx.
Структурированные данные и семантическая разметка
С 2025–2026 годов распространилась идея о необходимости размещения специальных текстовых манифестов для языковых моделей. Однако, согласно документации Google, создавать новые машиночитаемые файлы или особую разметку не требуется. Важно использовать стандартный словарь Schema.org для разрешения неоднозначности сущностей и валидации атрибутов.
Инженерия контента под извлечение пассажей (AEO / GEO)
Когда техническая доступность страницы обеспечена, важным становится то, как ранжировщик пассажей выбирает фрагмент для включения в ответ. Исследования показывают, что пользователи чаще всего обращают внимание на верхнюю треть сгенерированного блока. Для повышения точности извлечения каждый смысловой раздел должен быть самодостаточным и четко структурированным.
Как измерять эффективность и ставить воспроизводимые эксперименты
При внедрении GEO и AEO важно разделить работу на два контура: детерминированный технический контроль и наблюдательный анализ поисковых метрик. Детерминированные проверки должны включать конечный код ответа 200 OK, отсутствие блокирующих правил в robots.txt и наличие основного содержательного текста в первичном HTML-ответе. При анализе результатов в Google Search Console важно учитывать, что показы и клики из AI Overviews включаются в общую статистику.
Такой подход возвращает обсуждение GEO и AEO в инженерное русло, позволяя командам последовательно устранять преграды для индексации и формирования сниппетов, выстраивать чистый граф сущностей в разметке и проектировать структуру документов так, чтобы каждый раздел давал точный, проверяемый ответ как человеку, так и системе поиска.